MiniMax M3.1 Flash 正式发布:成本降 70%,速度提 3 倍
MiniMax M3.1 Flash 正式发布:成本降 70%,速度提 3 倍刚刚,MiniMax 正式发布了 M3.1 Flash
来自主题: AI资讯
9362 点击 2026-10-20 11:58

 搜索
刚刚,MiniMax 正式发布了 M3.1 Flash
MiniMax 更新 MiniMax M3.1 Flash,并确认此前处理超200万亿 Token 的匿名模型 Space Bunny 为其早期版本;官方称新模型线上推理速度提升近3倍,Agent 类任务综合使用成本较前代降低70%。
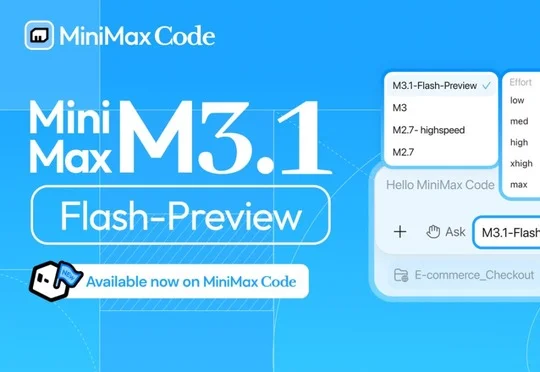
六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。
TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
RunningHub基于MiniMax H3开源基座发布增强版H3 RH Enhanced,2000组实测显示其多镜头长时叙事能力显著优于Seedance 2.0,16镜以上角色崩坏率降低超60%,生成成本低至0.1元/秒。
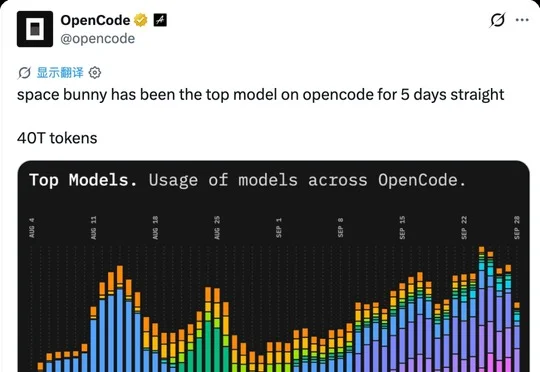
匿名AI模型Space Bunny Alpha(太空兔)近期凭借草图转网页、长上下文与Agent编程能力在OpenRouter和OpenCode平台刷屏并冲上日调用量第一,其分词特征与MiniMax M3.1系列高度吻合但尚无厂商官方认领。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
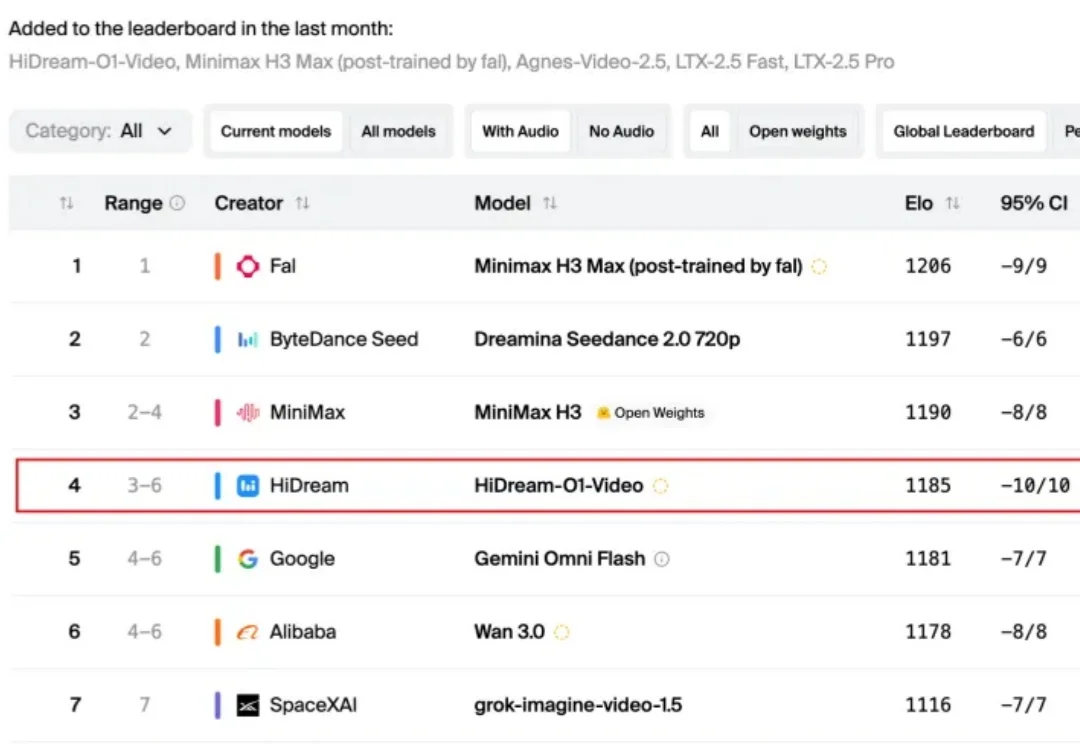
最近几个月,AI 视频赛道开始热起来了: Seedance2.0 发布后,AI 视频进入可用阶段,MiniMax H3 发布后,以 1/4 的价格,把 Seedance 2.0 的成本打了下去,AI 视频成本进入平价时代。
前几天,著名外宾AI应用 Genspark 干了一件以前不太像它会干的事。